GoogleがAI動画生成の課題を解決!一貫性のある長尺動画を自動生成するマルチエージェントフレームワークを発表
AI動画生成の新たな地平:Googleがマルチエージェントフレームワークを発表
Googleの研究者であるYale Song氏とYiwen Song氏が、時間的に一貫性のある長尺動画ナラティブを自律的に生成する統一されたマルチエージェントフレームワークを発表しました。これは、既存の線形AIパイプラインが抱える「アイデンティティドリフト」や「カスケード障害」といった課題を克服するためのものです。
近年の動画拡散モデルは、数秒でリアルなシーンをレンダリングできる高い忠実度を示していますが、それらを一貫性のある長尺のストーリーテリングエンジンに変えることは依然として困難でした。既存のエージェントパイプラインは、モジュールを連鎖させることでこのプロセスを自動化していましたが、独立した手作業のプロンプト作成により、キャラクターの服装や風景の微妙な変化(セマンティックドリフト)や、上流のアセットのアーティファクトが下流の動画合成を破壊する(カスケード障害)といった問題に悩まされていました。これらの初期エラーが伝播し、長期間の一貫性を損なうため、多くの場合、徹底的な手動介入が必要でした。
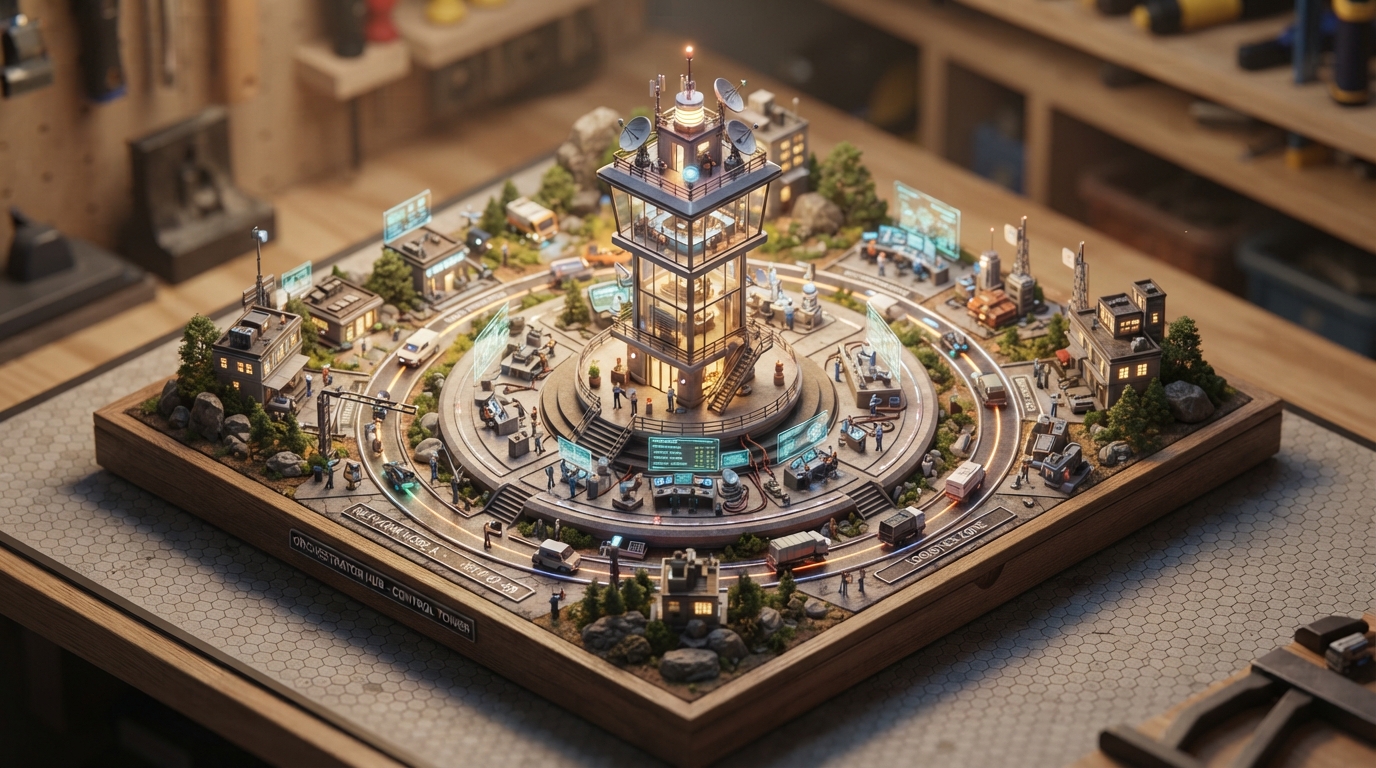
今回発表された「AI video co-director」は、GeminiとVeoの上にオーケストレーションレイヤーとして構築された統一されたマルチエージェントフレームワークです。これは、マルチショットナラティブにおける視覚的な連続性を明示的に計画します。長尺動画生成をグローバル最適化およびワールドステート追跡問題として扱うことで、Co-Director、CANVAS、A²RD、VQQAといった一連のフレームワークが開発されました。これらは、高レベルの人間による創造的な仕様を、マルチモデルプロンプト作成やショット連鎖から閉ループの視覚的洗練に至るまで、反復的なオーケストレーションタスクを自動化することで実行に移します。これにより、ユーザーは視覚的な連続性を維持する負担から解放され、ストーリーテリングという芸術に集中できるようになります。
どのように機能するのか?4つの柱
長尺動画の多面的な問題を解決するため、研究は4つの基礎的な柱に分解されました。
1. AI video co-directorによる創造的意図のオーケストレーション
動画全体にわたる意味論的な一貫性を確保するため、「AI video co-director」という階層的なマルチエージェントフレームワークが導入されました。これは、動画のストーリーテリングをグローバル最適化問題として形式化します。硬直した線形プロンプトチェーンに依存するのではなく、マルチアームバンディット(MAB)が有望な創造的方向性をグローバルに特定する階層的なパラメータ化が導入されています。これにより、創造的なプロセスが、新しいナラティブ戦略の探索と効果的な創造的構成の活用との最適なバランスを見つけるための探索として形式化されます。
このフレームワークはオーケストレーションレイヤーとして機能し、構造化されたプロンプトを基盤となるGeminiおよびVeoモデルに直接供給します。これにより、生成されるすべての画像、動画、音声には、SynthID透かしを含むネイティブの安全保護が組み込まれます。
パイプラインは、戦略的ステアリングと多段階制作という2つの相互接続されたループを通じてグローバル最適化を実行します。オーケストレーターエージェントは、MABアルゴリズムを使用して、創造的戦略、ナラティブモード、美的アーキタイプという3つの次元で創造的構成を選択します。プリプロダクションエージェントは、シーンごとの短いストーリーラインと視覚的アセットを統一されたストーリーボードに合成します。プロダクションエージェントは、このストーリーボードを具体的な視聴覚メディアに変換します。最後に、マルチモーダルLLM(MLLM)ジャッジがコンパイルされたカットを評価し、MABにフィードバックして反復的に選択肢を洗練し最適化します。
2. CANVASによる視覚的ストーリーボーディング
統一されたスクリプトがあっても、長尺の連続ショットを生成すると、キャラクターのドリフトや不安定な環境につながることがよくあります。これを解決するため、「Continuity-Aware Narratives via Visual Agentic Storyboarding (CANVAS)」というマルチエージェントフレームワークが導入されました。CANVASは、ナラティブの進化に合わせてキャラクター、場所、オブジェクトの状態の構造化された表現を維持することで、一貫性を強制します。Geminiの上にオーケストレーションレイヤーとして構築されており、永続的な視覚的メモリに依存しています。これにより、キャラクターはアイデンティティを保持し、環境は再訪時に空間構造を維持します。
3. A²RDによる時間的ダイナミクスのスケーリング
ストーリーボードを実際の数分間の動画に変換するため、「A²RD」というエージェント型自己回帰動画生成アーキテクチャが開発されました。A²RDは、セグメントごとの生成に、セグメントのコンテキストとダイナミクスを追跡するマルチモーダル動画メモリを組み合わせています。各セグメントについて、取得-合成-洗練-更新のループで動作します。このループの重要な部分は、エージェントがセグメント生成モードを適応的に決定する方法です。自然なナラティブの進行を可能にする外挿と、既存のエンティティや環境にセグメントを固定する内挿の間をスムーズに切り替えます。これにより、ストーリーが前進する必要性と、シーンの物理的現実を維持する必要性とのバランスが効果的に取られます。
4. VQQAによる閉ループの洗練
最後に、システムが視覚的なアーティファクトを自律的に特定し修正する方法が必要でした。